6 Base de datos
6.1 Generación y Caracterización del Conjunto de Datos
6.1.1 Construcción del Conjunto de Datos
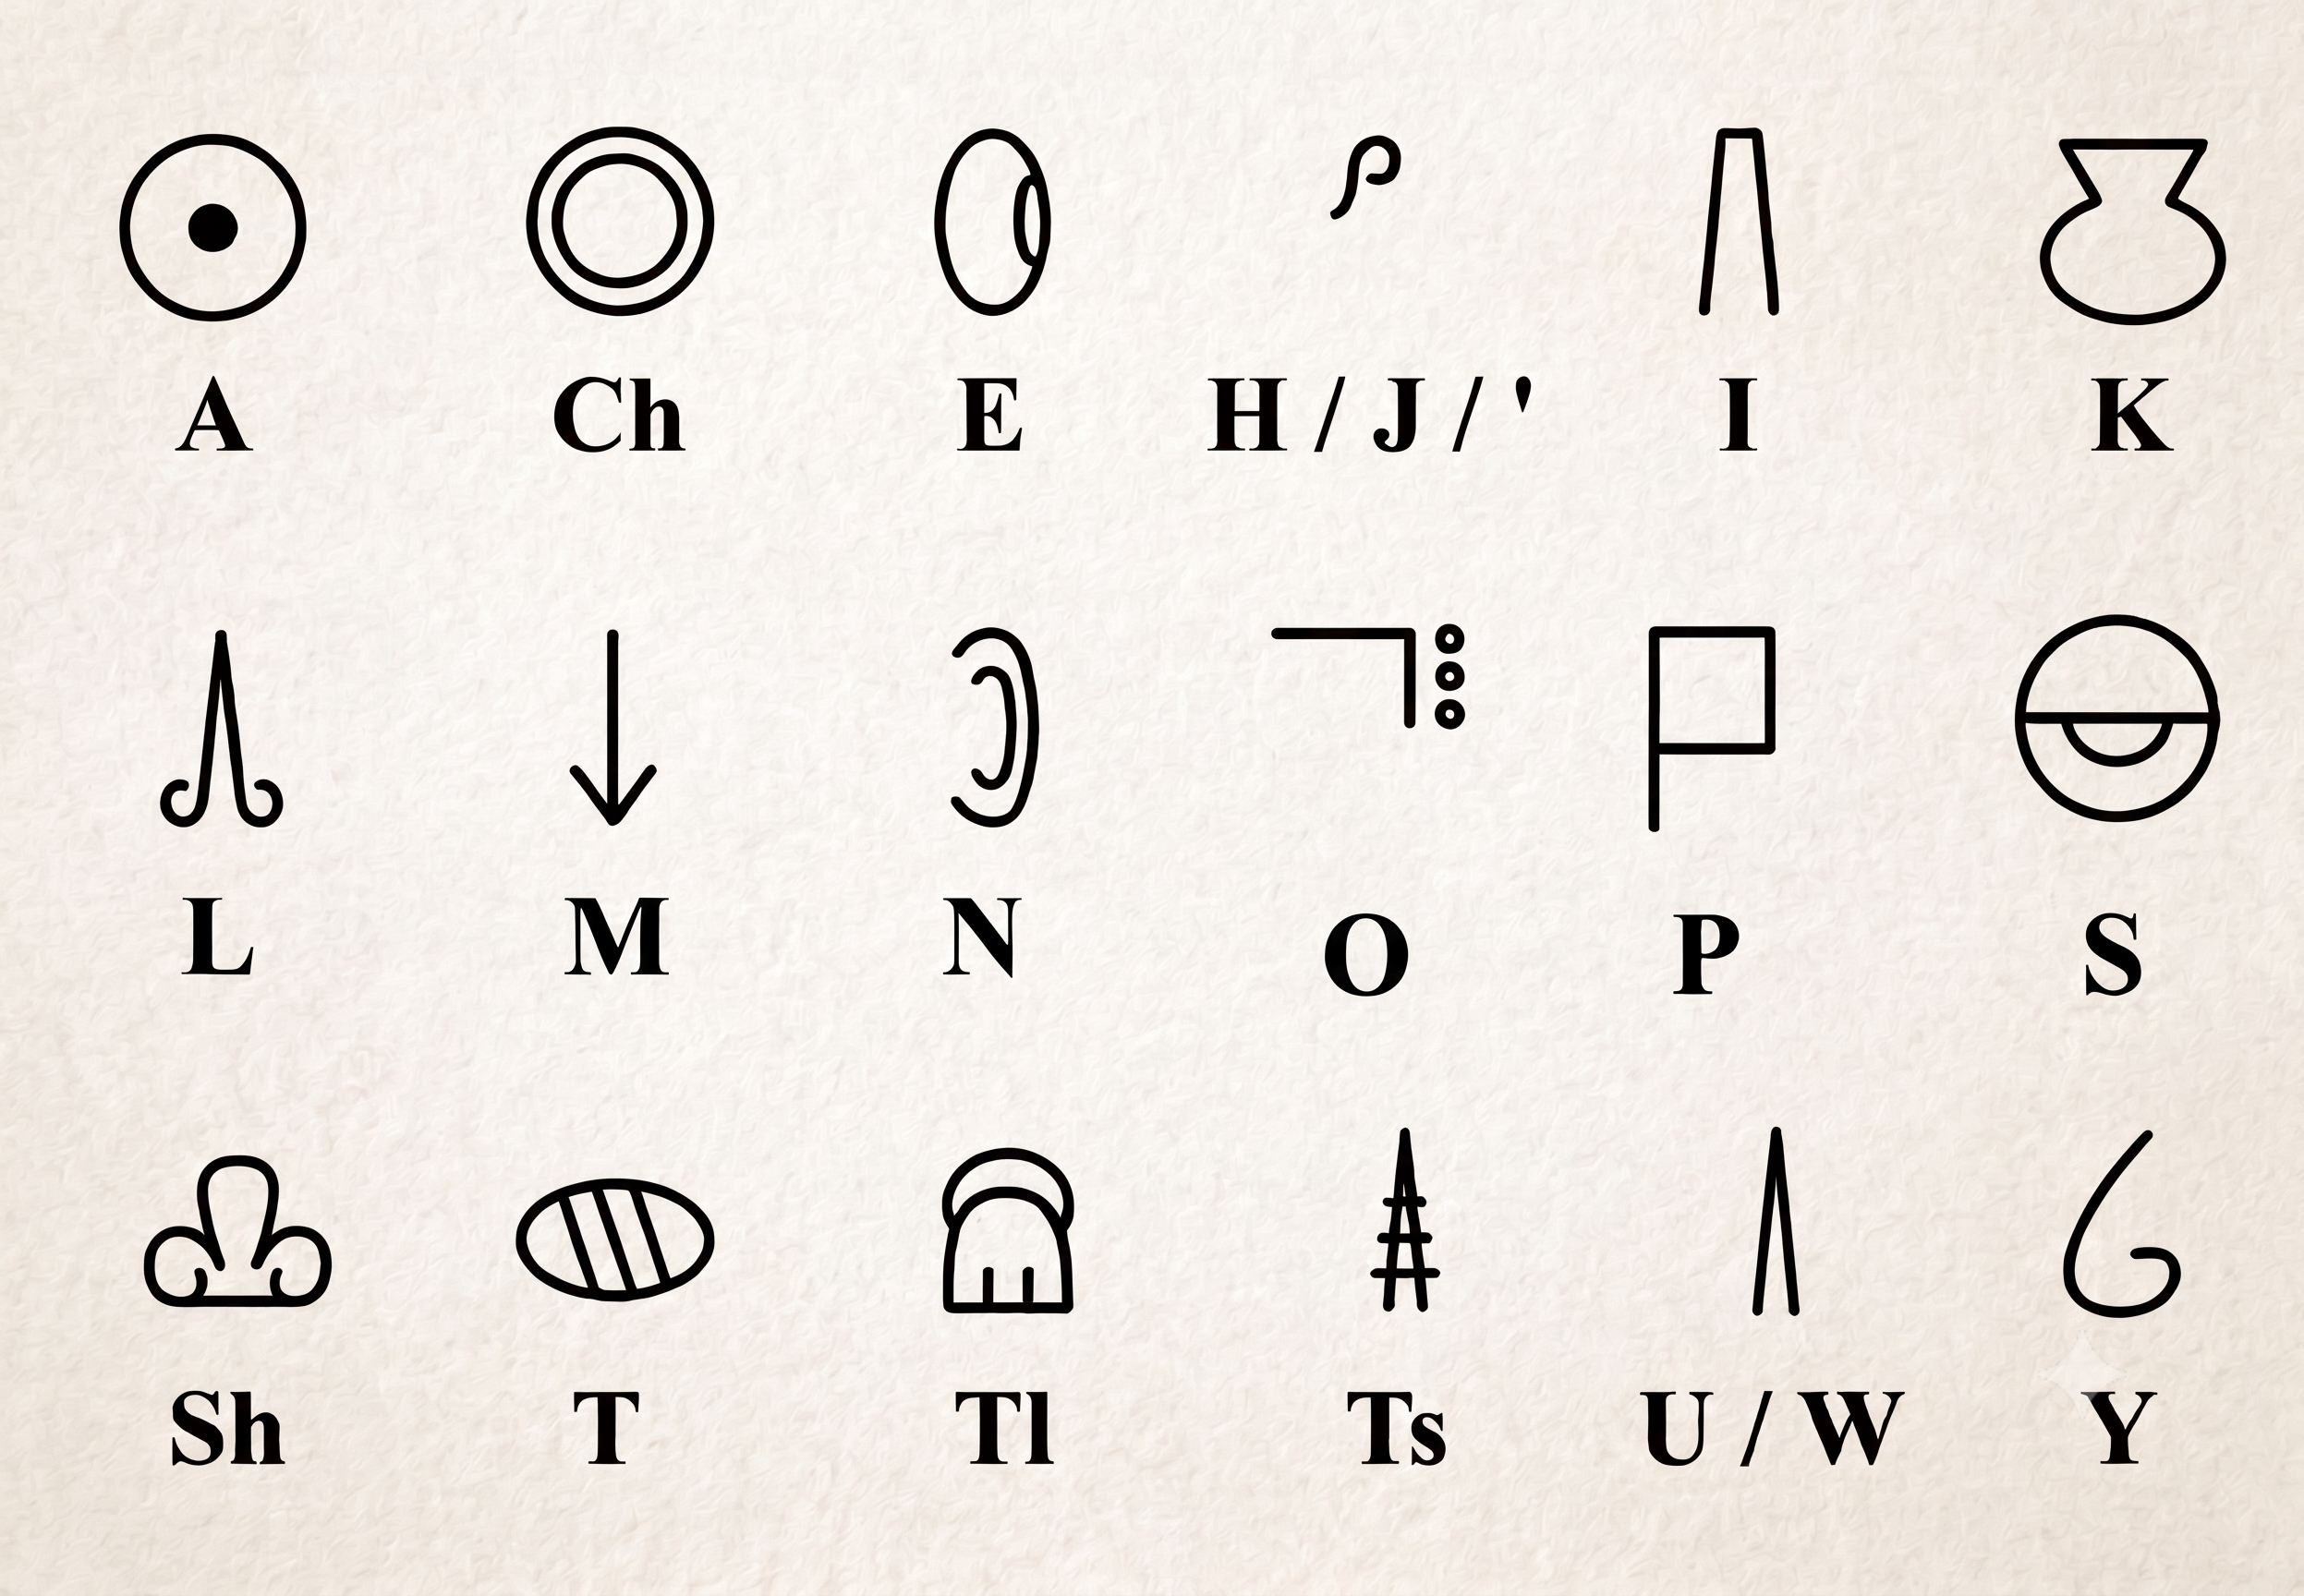
El reconocimiento óptico de caracteres para sistemas de escritura indígenas, particularmente para el alfabeto náhuatl (Figura 4.1), presenta una limitación inicial crítica: la inexistencia de un conjunto de datos público, estandarizado y etiquetado que permita entrenar modelos de aprendizaje profundo. A diferencia de alfabetos latinos o asiáticos, que cuentan con repositorios ampliamente documentados (como MNIST o EMNIST), el dominio de los glifos náhuatl carece de recursos computacionales de código abierto.
Figura 4.1: Glifos del alfabeto náhuatl. Este sistema consta de 18 caracteres base, los cuales, para fines de manipulación computacional, se asocian a etiquetas del alfabeto latino.
6.1.2 Inexistencia de datasets públicos y justificación de la generación sintética
Ante esta carencia de una base de datos pública y estandarizada, fue necesario construir un conjunto de datos propio. La decisión de generar un dataset sintético se fundamenta en dos razones principales: 1. Volumen de datos: Proporcionar un número suficiente de ejemplos para evitar el sobreajuste en redes neuronales profundas. 2. Variabilidad controlada: Introducir deformaciones geométricas y estocásticas que permitan al modelo generalizar ante las irregularidades presentes en documentos históricos reales (desalineación, degradación de tinta, variabilidad del trazo).
6.1.3 Diseño de las plantillas base y morfología del glifo náhuatl
Inicialmente, se diseñaron de forma manual y vectorial 25 plantillas base por cada uno de los 18 caracteres. Este diseño no fue arbitrario; se basó en el análisis morfológico de los glifos, los cuales se caracterizan por una combinación de trazos curvos, segmentos rectos, puntos diacríticos y bucles cerrados. La representación base se normalizó a una cuadrícula de \(28 \times 28\) píxeles, preservando la proporción y densidad de “tinta” típica de los códices, estableciendo así un punto de partida topológicamente válido para la posterior augmentación.
6.2 Transformaciones Geométricas y Estocásticas (Data Augmentation)
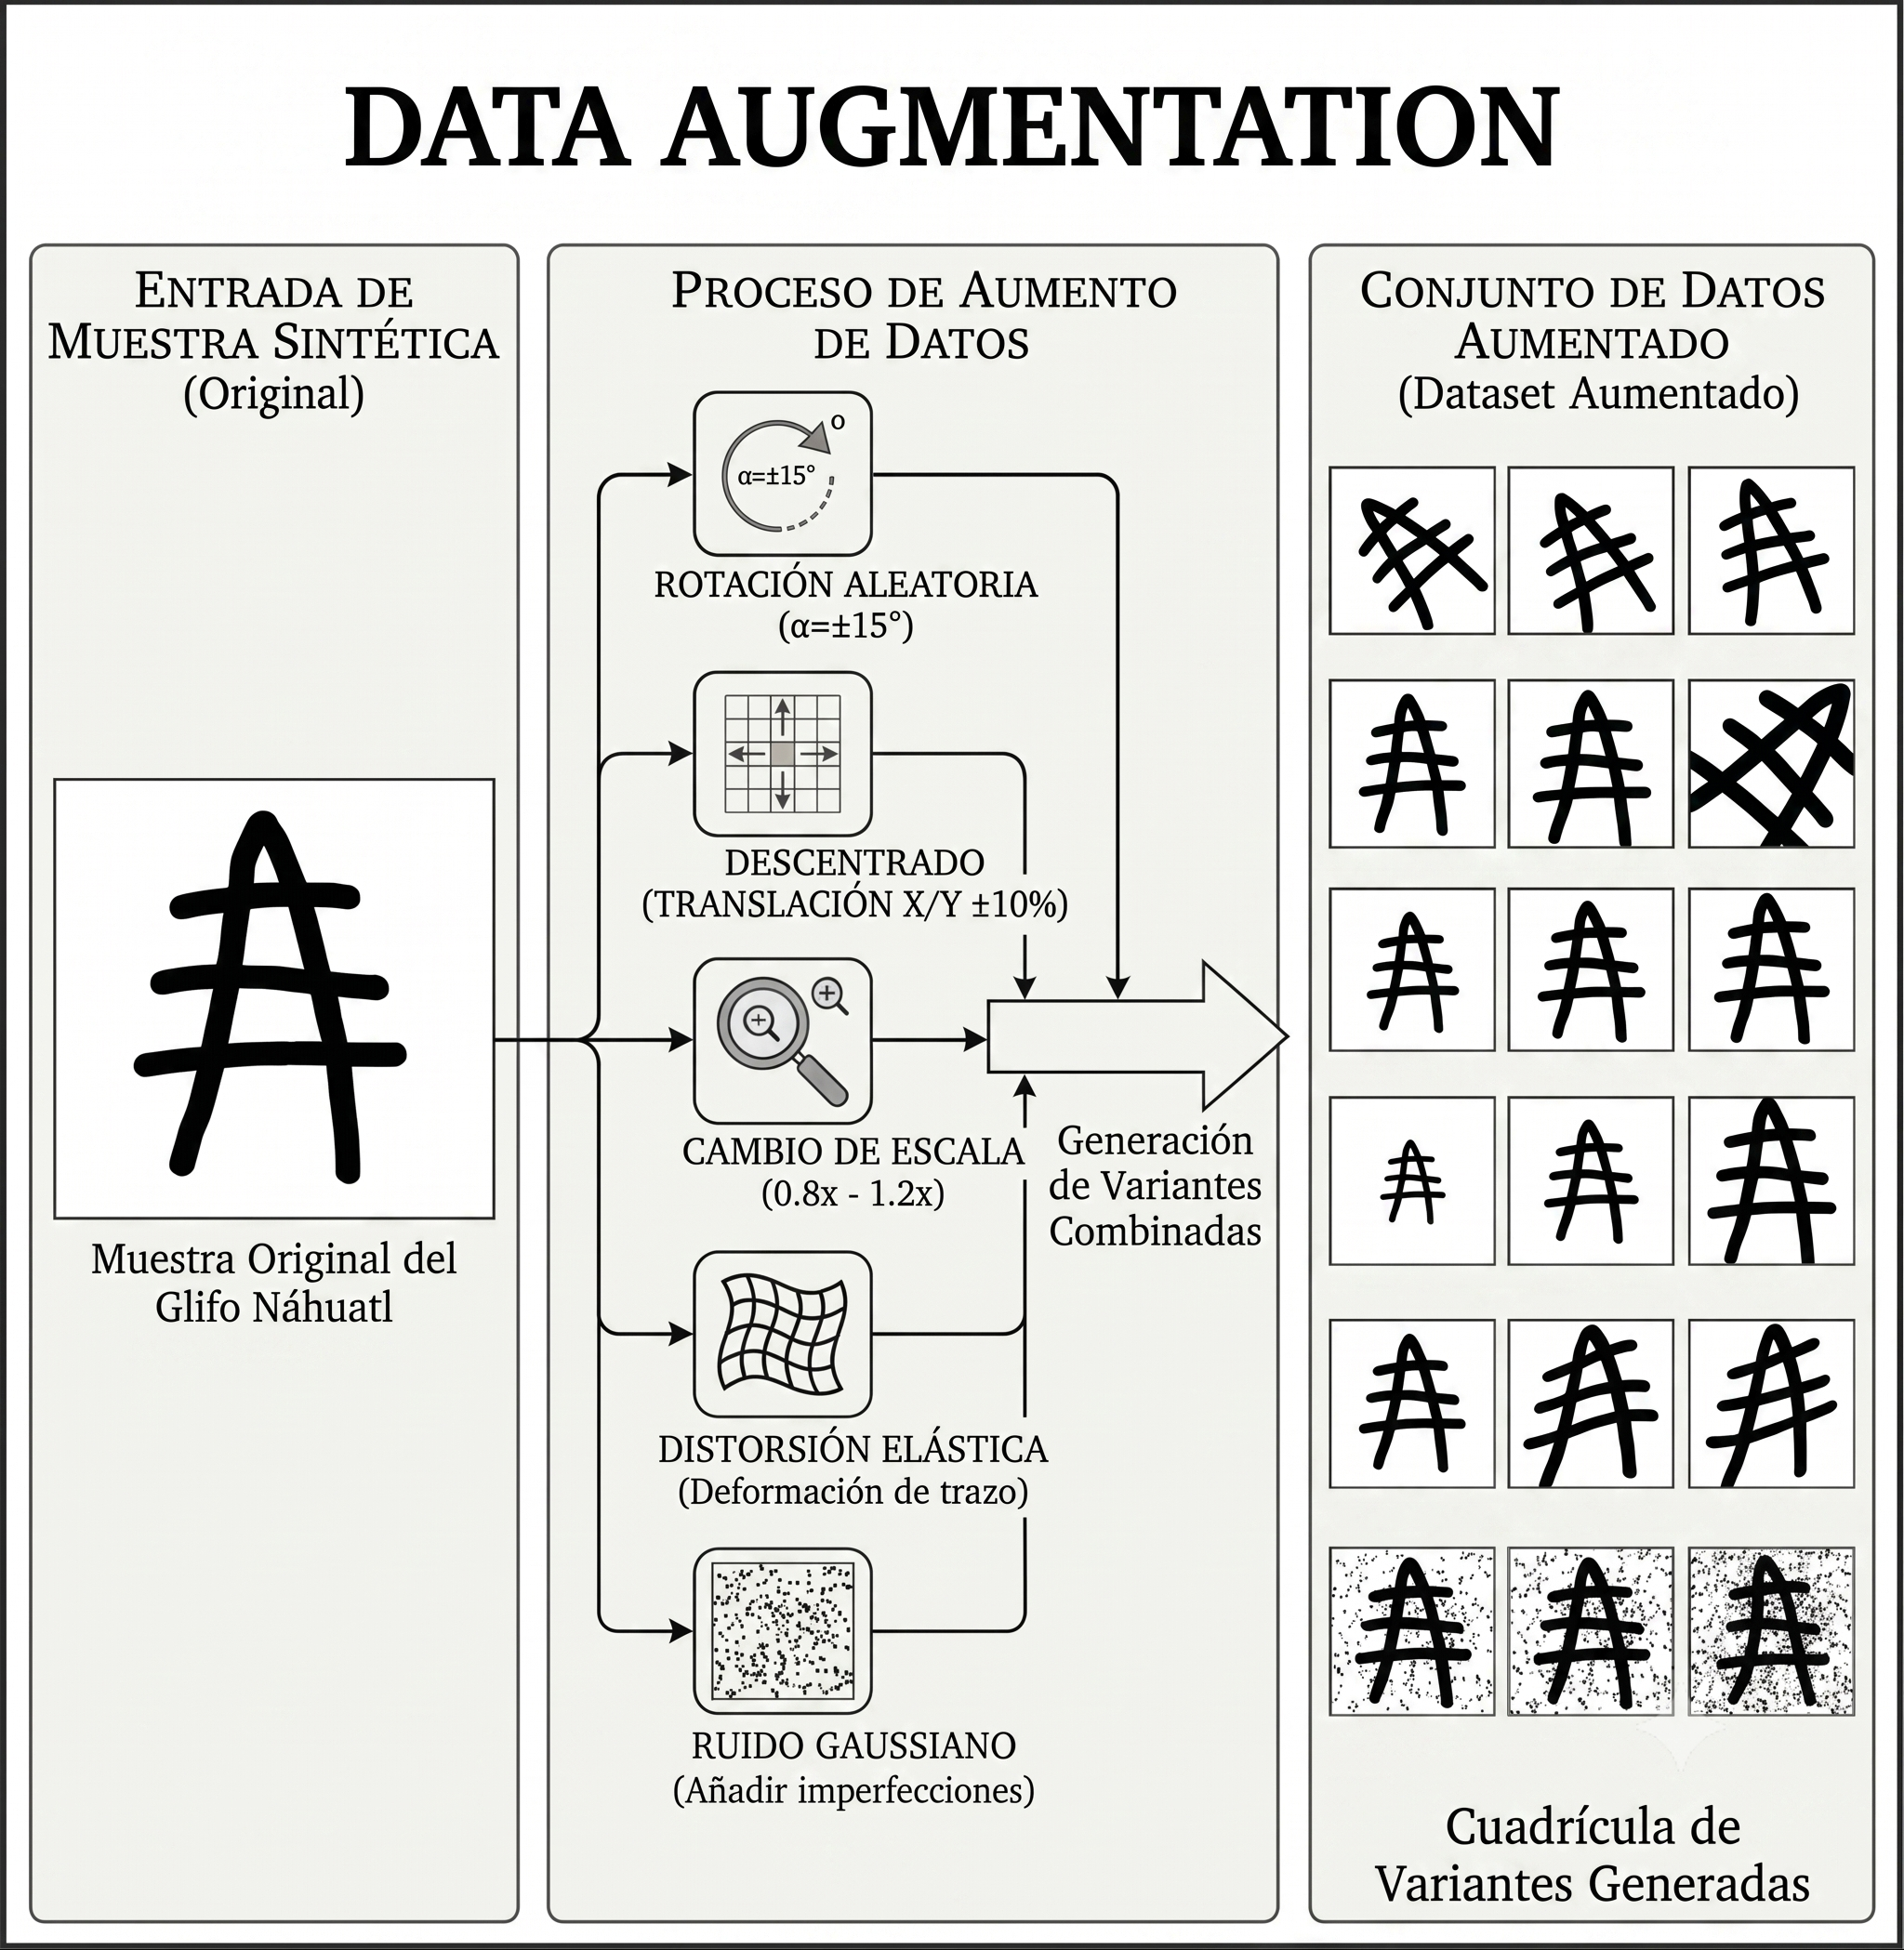
Para emular las condiciones de documentos, se aplicaron transformaciones a las plantillas base. A cada una de las 25 muestras iniciales se le generaron 90 variantes, resultando en un conjunto robusto y diverso.
6.2.1 Aplicación de grupos de Lie en transformaciones afines
Las transformaciones geométricas aplicadas (rotación, traslación y escalamiento) pueden formalizarse como acciones del grupo afín \(Aff(2)\) sobre el espacio de la imagen. Una transformación afín se expresa como:
\[ \begin{pmatrix} x' \\ y' \end{pmatrix} = \begin{pmatrix} s_x \cos\theta & -s_y \sin\theta \\ s_x \sin\theta & s_y \cos\theta \end{pmatrix} \begin{pmatrix} x \\ y \end{pmatrix} + \begin{pmatrix} t_x \\ t_y \end{pmatrix} \]
donde \(\theta\) representa la rotación, \((t_x, t_y)\) la traslación, y \((s_x, s_y)\) los factores de escalamiento. En la implementación práctica, se utilizaron operadores estocásticos acotados (ej. \(\theta \sim \mathcal{U}(-0.05\pi, 0.05\pi)\)) para garantizar que la identidad del glifo se preservara semánticamente.
6.2.2 Modelado de ruido y degradación
Para simular la naturaleza física del papel histórico y la tinta, se inyectaron perturbaciones estocásticas: - Ruido aditivo: Se modeló como ruido blanco gaussiano \(\mathcal{N}(0, \sigma^2)\) para emular las imperfecciones del sensor de escaneo. - Degradación de bordes: Se aplicó un desenfoque gaussiano leve para simular el “sangrado” de la tinta en el papel poroso.
6.2.3 Análisis estadístico del dataset resultante
El proceso generó un dataset final balanceado de \(18 \times 25 \times 90 = 40,500\) imágenes. Al ser sintético, el balance de clases es adecuado (exactamente 2,250 muestras por clase), este tamaño es el estandard y usual al trabajar para reconocimiento de patrones. La varianza intra-clase fue maximizada de manera controlada mediante las transformaciones afines, asegurando que el modelo no aprenda artefactos de la plantilla base, sino las invariantes morfológicas del carácter.
6.3 Mapeo Dimensional: De \(\mathbb{R}^{28 \times 28}\) a \(\mathbb{R}^T\)
La pérdida de información topológica al proyectar una imagen en una secuencia temporal.
Para abordar el reconocimiento desde una perspectiva de secuencias, es necesario proyectar la representación bidimensional de la imagen \(X \in \mathbb{R}^{H \times W}\) en una secuencia unidimensional de vectores \(S \in \mathbb{R}^T\). Este mapeo implica una pérdida inherente de la topología 2D (vecindades verticales y horizontales simultáneas), la cual debe ser compensada mediante la extracción de rasgos estructurales ricos en cada paso de tiempo.
6.3.1 Definición del operador de ventana deslizante vertical
Se define un operador de ventana deslizante vertical que recorre la imagen de izquierda a derecha. Para una imagen \(X\) de ancho \(W\), se extraen \(T\) ventanas de ancho \(w\) y stride \(s\), donde \(T = \lfloor \frac{W - w}{s} \rfloor + 1\). Cada elemento de la secuencia \(S_t \in \mathbb{R}^{H \times w}\) representa una “rebanada” vertical de la imagen en el paso de tiempo \(t\), preservando la estructura vertical del trazo en ese instante.
6.4 Extracción Matemática de Rasgos Estructurales (Feature Engineering)
Para mitigar la pérdida topológica mencionada, se extraen descriptores matemáticos de cada ventana \(S_t\).
6.4.1 Cálculo del Centro de Gravedad
El primer momento de la distribución de “tinta” (intensidad de píxeles) proporciona el centroide local de la masa del trazo. Para una ventana \(S_t\), las coordenadas del centro de gravedad \((\mu_x, \mu_y)\) se calculan como:
\[ \mu_x = \frac{\sum_{i,j} j \cdot S_t(i,j)}{\sum_{i,j} S_t(i,j)}, \quad \mu_y = \frac{\sum_{i,j} i \cdot S_t(i,j)}{\sum_{i,j} S_t(i,j)} \]
Este rasgo es invariante a traslaciones globales y altamente discriminativo para la morfología del glifo.
6.4.2 Transiciones de estado y cruces por cero
Se analiza la derivada discreta del perfil de proyección horizontal de la ventana. Los cruces por cero de esta derivada indican la presencia de múltiples trazos horizontales superpuestos o la transición entre el fondo y la tinta, proporcionando información sobre la complejidad estructural local.
6.4.3 Perfiles superior e inferior (Envoltura convexa)
Se calculan los perfiles superior \(P_{sup}\) e inferior \(P_{inf}\) de la ventana, definidos como los índices de fila mínimo y máximo, respectivamente, donde la intensidad del píxel supera un umbral \(\tau\). La diferencia \(P_{sup} - P_{inf}\) define el espesor local del trazo, actuando como una aproximación discreta de la envoltura convexa del carácter en esa columna.
6.5 Cuantificación y Discretización del Espacio de Observaciones
Para alimentar modelos que requieren espacios de observación discretos, el espacio continuo de rasgos debe ser discretizado.
6.5.1 Función de cuantificación por intervalos (Binning)
Dado un rasgo continuo \(v \in [v_{min}, v_{max}]\), se aplica una función de cuantificación uniforme que lo mapea a uno de \(N\) intervalos (bins):
\[ q(v) = \left\lfloor \frac{v - v_{min}}{v_{max} - v_{min}} \times N \right\rfloor \]
6.5.2 Codificación binaria y construcción del alfabeto de 256 símbolos observables
Combinando los rasgos cuantificados (por ejemplo, centroide Y, espesor del trazo y perfil superior), se construye un vector de características que se codifica en una representación binaria de 8 bits. Esto permite definir un alfabeto discreto de exactamente 256 símbolos observables (\(2^8\)), donde cada símbolo representa una configuración estructural local única de la ventana deslizante.
6.5.3 Análisis de la entropía de Shannon de las secuencias generadas
La riqueza informativa de las secuencias generadas se valida mediante la entropía de Shannon \(H(S)\) de la distribución de símbolos en el dataset:
\[ H(S) = - \sum_{i=1}^{256} p(s_i) \log_2 p(s_i) \]
Una entropía alta indica que el proceso de generación sintética y extracción de rasgos produce una diversidad de patrones locales rica y no redundante, lo cual es un prerrequisito fundamental para que un modelo de aprendizaje automático pueda aprender representaciones discriminativas y generalizar adecuadamente.
(Nota: El código de carga de datos en TensorFlow que tenías originalmente es totalmente válido y se puede insertar como una subsección práctica al final, por ejemplo, bajo un “4.6. Implementación Computacional del Pipeline”, si tu director lo permite, o integrarlo como ejemplos dentro de las secciones anteriores).
6.6 Construcción del conjunto de datos
El reconocimiento óptico de caracteres para sistemas de escritura indígenas, particularmente para el alfabeto Náhuatl Figura 6.1, presenta una limitación inicial importante: no existe un conjunto de datos público, estandarizado y etiquetado que permita entrenar modelos de aprendizaje profundo. A diferencia de otros alfabetos, para los cuales existen repositorios ampliamente documentados, el alfabeto Náhuatl carece de recursos computacionales que puedan emplearse directamente en tareas de clasificación automática.
Ante esta situación, fue necesario construir un conjunto de datos propio. La decisión de generar un dataset sintético se tomó por dos razones principales:
- Proporcionar un número suficiente de ejemplos para el entrenamiento de la red neuronal.
- Introducir variaciones geométricas que permitan al modelo generalizar ante deformaciones presentes en documentos reales.
6.6.1 Generación de las muestras
Inicialmente se diseñaron de forma manual 25 ejemplos base para cada carácter del alfabeto. Posteriormente, a cada muestra se le aplicaron transformaciones geométricas y perturbaciones aleatorias para incrementar la variabilidad del conjunto de datos.
La Figura Figura 6.2 muestra algunos ejemplos de las imágenes generadas.
6.7 Carga y organización de los datos
Una vez construido el conjunto de datos, las imágenes se almacenaron siguiendo una estructura jerárquica de directorios, donde cada carpeta representa una clase distinta del alfabeto.
El cargado de las imágenes se realizó mediante la función image_dataset_from_directory de TensorFlow:
train_ds = tf.keras.utils.image_dataset_from_directory(
    data_dir,
    validation_split=0.2,
    subset="training",
    seed=123,
    image_size=(28,28),
    batch_size=32,
    color_mode="grayscale"
)

val_ds = tf.keras.utils.image_dataset_from_directory(
    data_dir,
    validation_split=0.2,
    subset="validation",
    seed=123,
    image_size=(28,28),
    batch_size=32,
    color_mode="grayscale"
)
La elección de una partición de entrenamiento-validación de 80%-20% constituye una práctica común en aprendizaje automático, ya que permite disponer de un número suficiente de ejemplos para el ajuste de los parámetros del modelo y, al mismo tiempo, reservar un conjunto independiente para evaluar la capacidad de generalización.
Asimismo, las imágenes se convirtieron a escala de grises. Dado que los glifos del alfabeto Náhuatl se distinguen principalmente por su geometría y no por información cromática, el uso de un solo canal reduce el costo computacional sin sacrificar información relevante.
6.8 Normalización y aumentación de datos
Antes de alimentar las imágenes a la red neuronal, se realizó un proceso de normalización:
normalization_layer = tf.keras.layers.Rescaling(1./255)Esta transformación reescala los valores de intensidad al intervalo \([0,1]\), lo cual mejora la estabilidad numérica del proceso de entrenamiento y facilita la convergencia del algoritmo de optimización.
Adicionalmente, se implementó un mecanismo de aumentación de datos en línea:
data_augmentation = tf.keras.Sequential([
    tf.keras.layers.RandomRotation(0.05),
    tf.keras.layers.RandomZoom(0.1),
    tf.keras.layers.RandomTranslation(0.05, 0.05)
])
La introducción de pequeñas rotaciones, cambios de escala y traslaciones tiene como objetivo simular las variaciones presentes en documentos escaneados o en la escritura manual. De esta manera, el modelo aprende representaciones más robustas y reduce su tendencia al sobreajuste.
Finalmente, los datos fueron almacenados temporalmente en memoria y preparados para alimentar la GPU:
train_ds = train_ds.cache().shuffle(5000).prefetch(AUTOTUNE)
val_ds = val_ds.cache().prefetch(AUTOTUNE)
El uso de cache() evita que las imágenes sean leídas repetidamente desde el disco, mientras que prefetch() permite superponer las operaciones de lectura de datos con el entrenamiento de la red, disminuyendo el tiempo total de ejecución.