4 Base de datos
4.1 Construcción del conjunto de datos
El reconocimiento óptico de caracteres para sistemas de escritura indígenas, particularmente para el alfabeto Náhuatl Figura 4.1, presenta una limitación inicial importante: no existe un conjunto de datos público, estandarizado y etiquetado que permita entrenar modelos de aprendizaje profundo. A diferencia de otros alfabetos, para los cuales existen repositorios ampliamente documentados, el alfabeto Náhuatl carece de recursos computacionales que puedan emplearse directamente en tareas de clasificación automática.
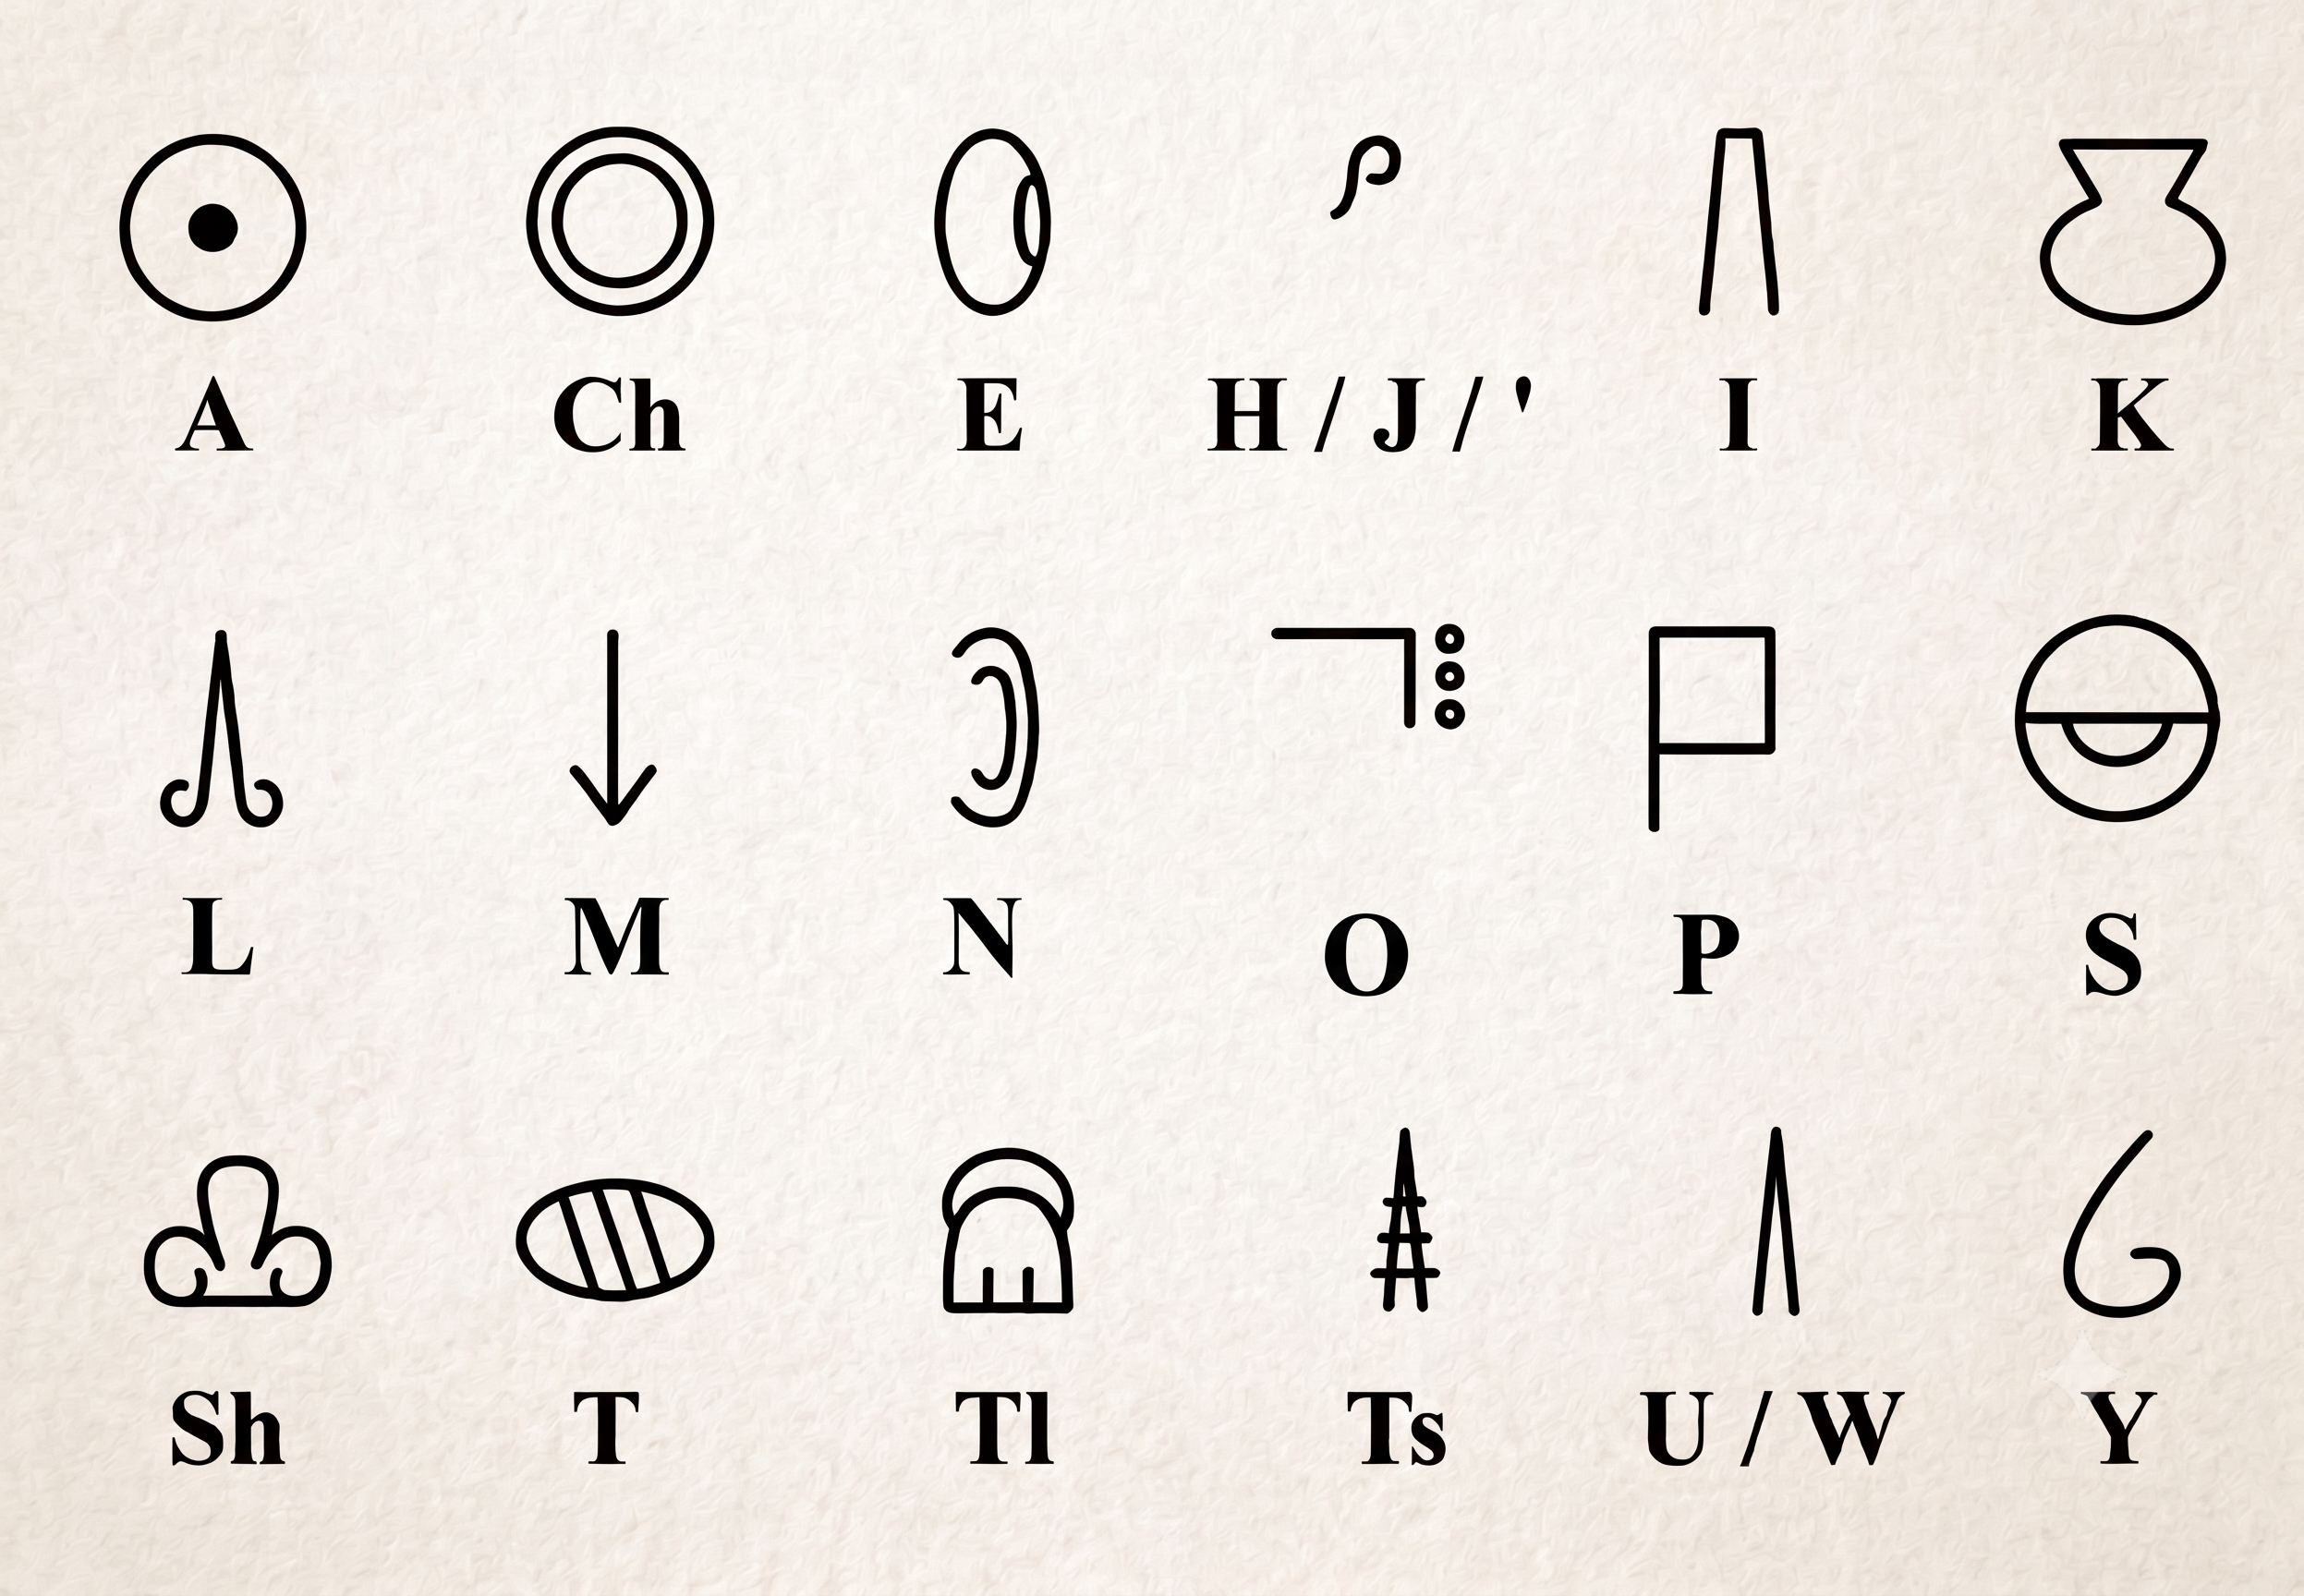
Ante esta situación, fue necesario construir un conjunto de datos propio. La decisión de generar un dataset sintético se tomó por dos razones principales:
- Proporcionar un número suficiente de ejemplos para el entrenamiento de la red neuronal.
- Introducir variaciones geométricas que permitan al modelo generalizar ante deformaciones presentes en documentos reales.
4.1.1 Generación de las muestras
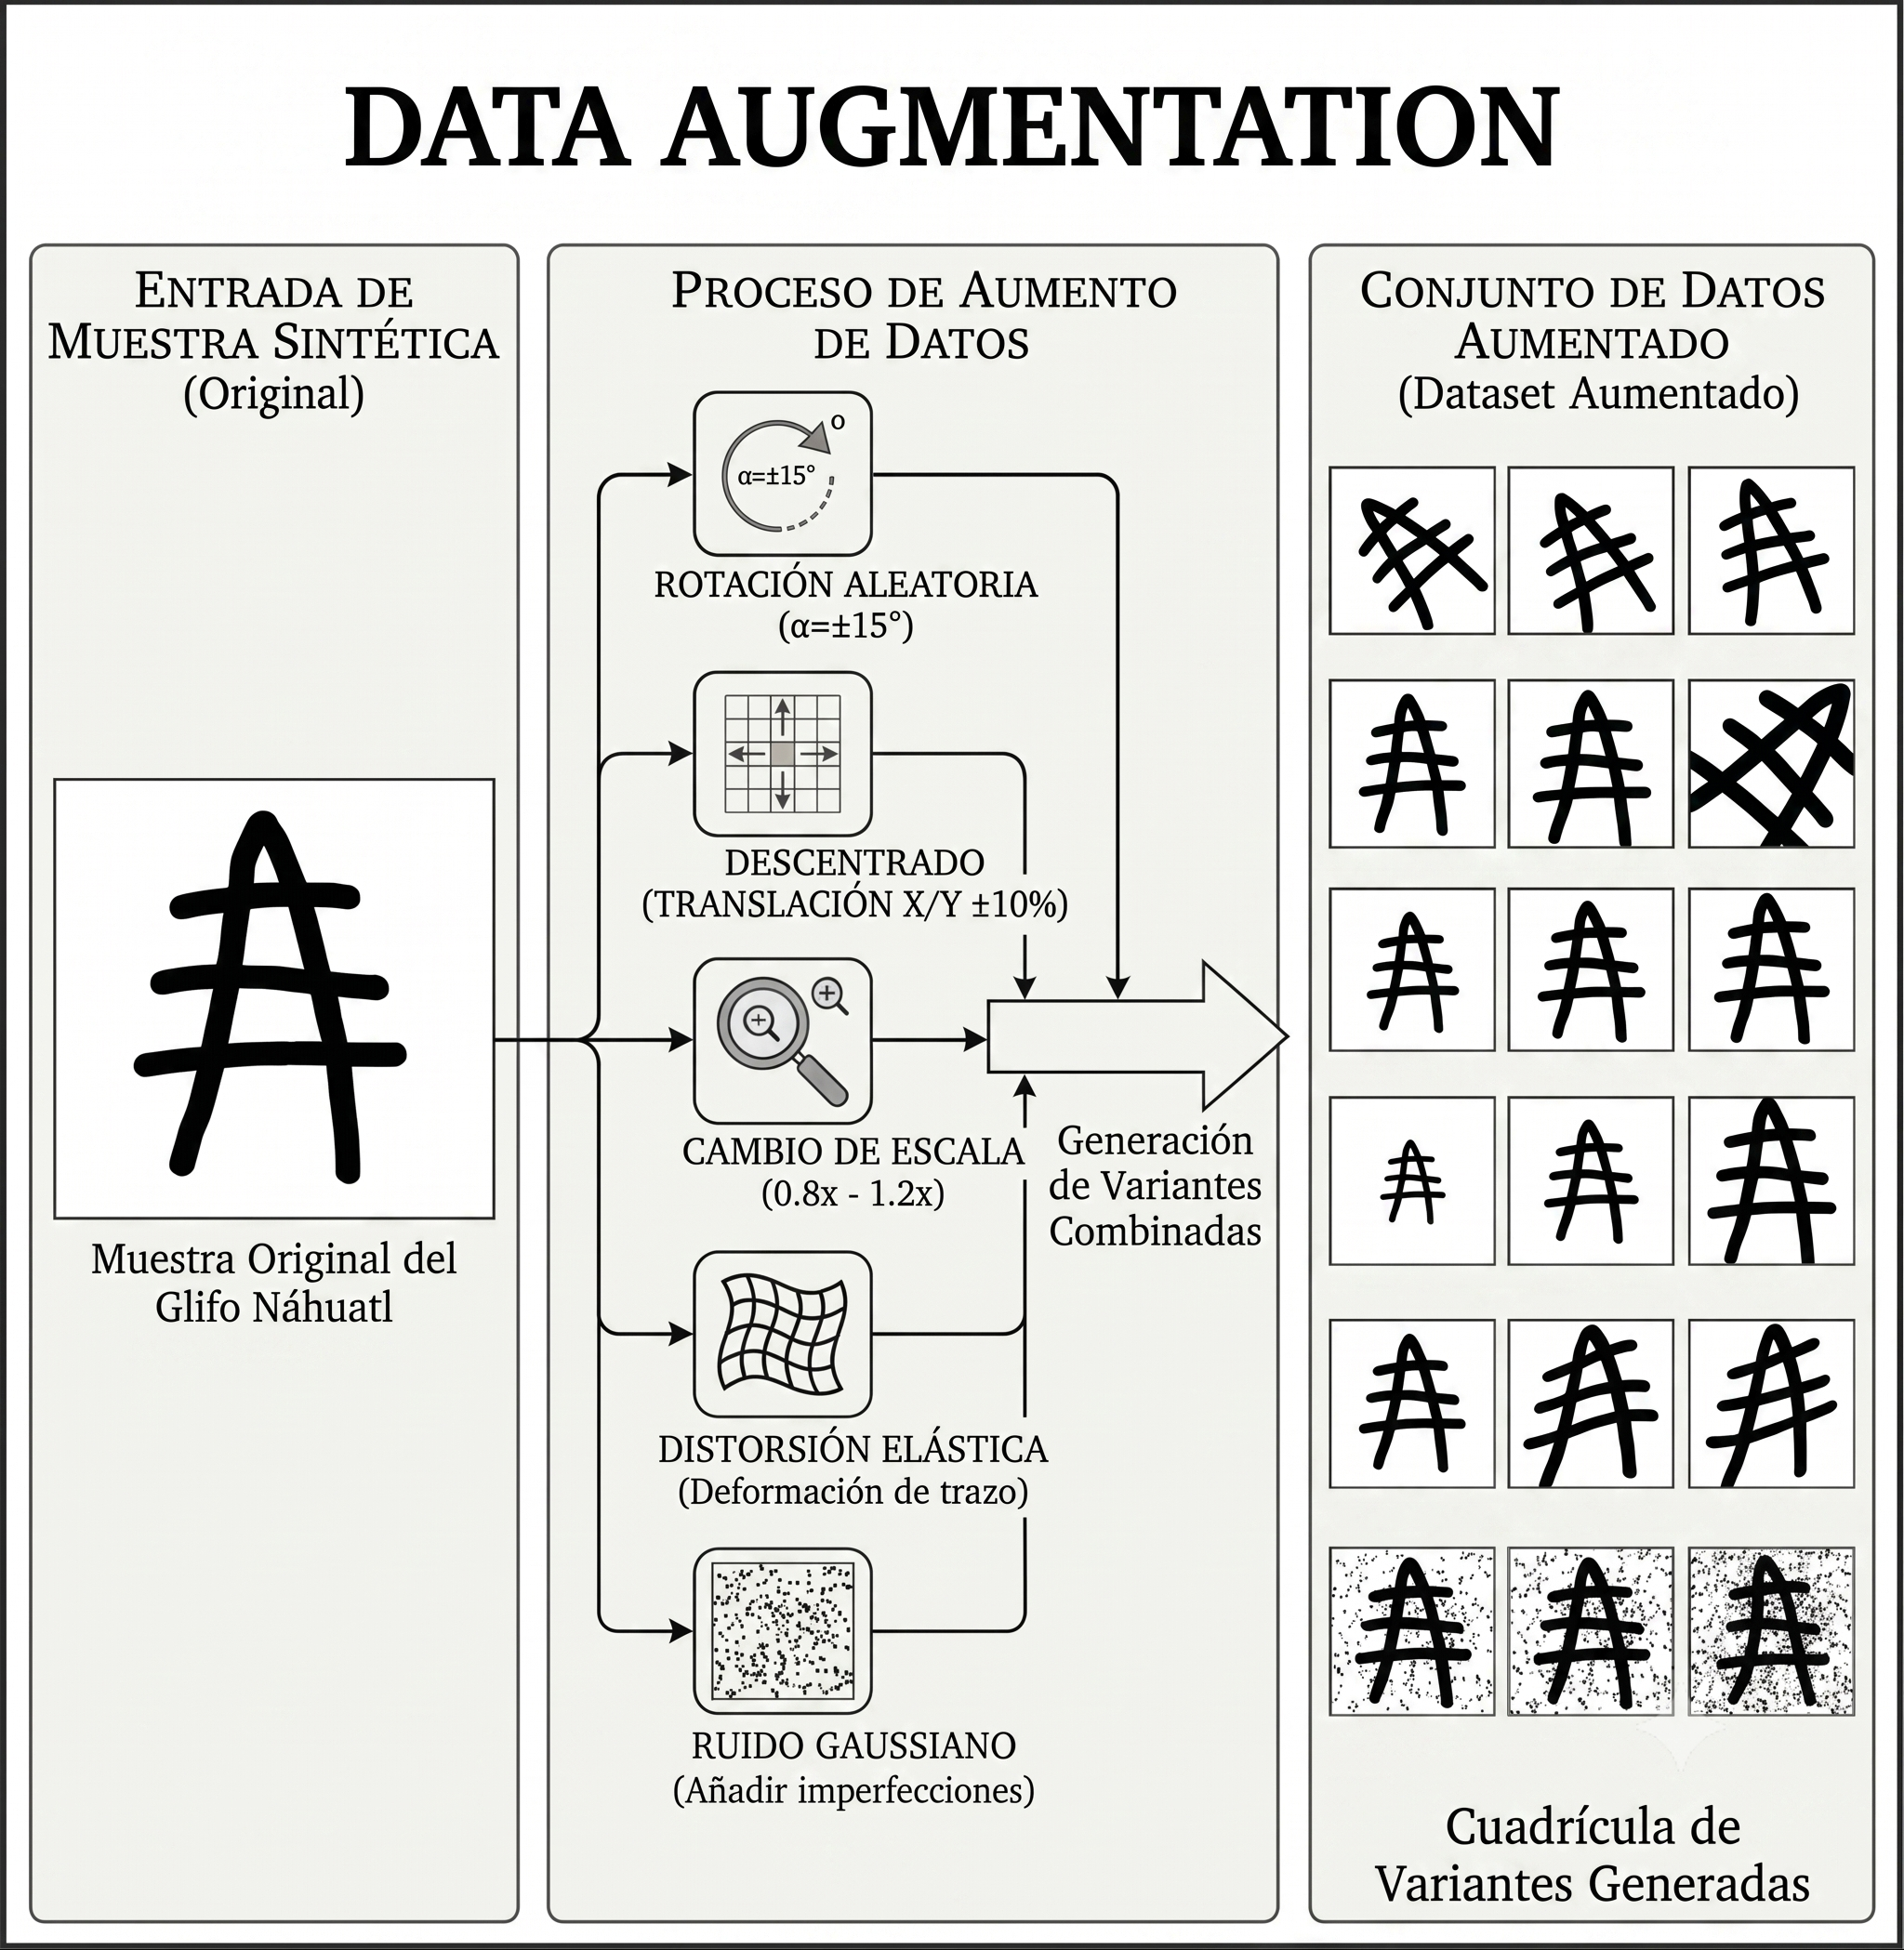
Inicialmente se diseñaron de forma manual 25 ejemplos base para cada carácter del alfabeto. Posteriormente, a cada muestra se le aplicaron transformaciones geométricas y perturbaciones aleatorias para incrementar la variabilidad del conjunto de datos.
La Figura Figura 4.2 muestra algunos ejemplos de las imágenes generadas.
4.2 Carga y organización de los datos
Una vez construido el conjunto de datos, las imágenes se almacenaron siguiendo una estructura jerárquica de directorios, donde cada carpeta representa una clase distinta del alfabeto.
El cargado de las imágenes se realizó mediante la función image_dataset_from_directory de TensorFlow:
train_ds = tf.keras.utils.image_dataset_from_directory(
    data_dir,
    validation_split=0.2,
    subset="training",
    seed=123,
    image_size=(28,28),
    batch_size=32,
    color_mode="grayscale"
)

val_ds = tf.keras.utils.image_dataset_from_directory(
    data_dir,
    validation_split=0.2,
    subset="validation",
    seed=123,
    image_size=(28,28),
    batch_size=32,
    color_mode="grayscale"
)
La elección de una partición de entrenamiento-validación de 80%-20% constituye una práctica común en aprendizaje automático, ya que permite disponer de un número suficiente de ejemplos para el ajuste de los parámetros del modelo y, al mismo tiempo, reservar un conjunto independiente para evaluar la capacidad de generalización.
Asimismo, las imágenes se convirtieron a escala de grises. Dado que los glifos del alfabeto Náhuatl se distinguen principalmente por su geometría y no por información cromática, el uso de un solo canal reduce el costo computacional sin sacrificar información relevante.
4.3 Normalización y aumentación de datos
Antes de alimentar las imágenes a la red neuronal, se realizó un proceso de normalización:
normalization_layer = tf.keras.layers.Rescaling(1./255)Esta transformación reescala los valores de intensidad al intervalo \([0,1]\), lo cual mejora la estabilidad numérica del proceso de entrenamiento y facilita la convergencia del algoritmo de optimización.
Adicionalmente, se implementó un mecanismo de aumentación de datos en línea:
data_augmentation = tf.keras.Sequential([
    tf.keras.layers.RandomRotation(0.05),
    tf.keras.layers.RandomZoom(0.1),
    tf.keras.layers.RandomTranslation(0.05, 0.05)
])
La introducción de pequeñas rotaciones, cambios de escala y traslaciones tiene como objetivo simular las variaciones presentes en documentos escaneados o en la escritura manual. De esta manera, el modelo aprende representaciones más robustas y reduce su tendencia al sobreajuste.
Finalmente, los datos fueron almacenados temporalmente en memoria y preparados para alimentar la GPU:
train_ds = train_ds.cache().shuffle(5000).prefetch(AUTOTUNE)
val_ds = val_ds.cache().prefetch(AUTOTUNE)
El uso de cache() evita que las imágenes sean leídas repetidamente desde el disco, mientras que prefetch() permite superponer las operaciones de lectura de datos con el entrenamiento de la red, disminuyendo el tiempo total de ejecución.